✨ 我是 Muzi 的「文章捕手」,擅长在文字的星海中打捞精华。每当新的篇章诞生,我就会像整理贝壳一样,将思想的闪光点串成珍珠项链~
文章介绍了Mu-ai-agent-13版本中检索结果后处理机制的设计与实现,基于Spring AI 1.1.8的开放接口,构建了五个顺序固定的处理器链路:过滤、去重、重排、预算和增强。该体系通过阈值过滤保证相关性,内容与ID双重去重减少冗余,多种重排策略提升信息密度,上下文预算控制条数及Token数,并在最终文档中补充元数据信息以辅助调优。配置项集中管理,默认配置开启零成本稳妥环节,确保兼容性。文章还提供了详细的算法原理示意和单元测试覆盖,验证了设计的有效性与稳定性,为后续生成阶段上下文注入与拒答机制奠定基础,具有较强的实用价值和技术创新点。
# Mu-ai-agent-13
# 前言
#12 讲完了检索阶段:怎么从向量库把文档取回来、多路结果怎么合并。这一篇继续往下走 —— 文档取回来之后、拼进 prompt 之前还能做什么优化。
Spring AI 1.1.8 给后处理只留了一个 DocumentPostProcessor 接口,没有任何内置实现。也就是说这一环完全开放,要啥自己写。本篇把实际落地的五个处理器串成一条固定顺序的链路:过滤 → 去重 → 重排 → 预算 → 增强。
# 图一:检索后处理在整条链路中的位置
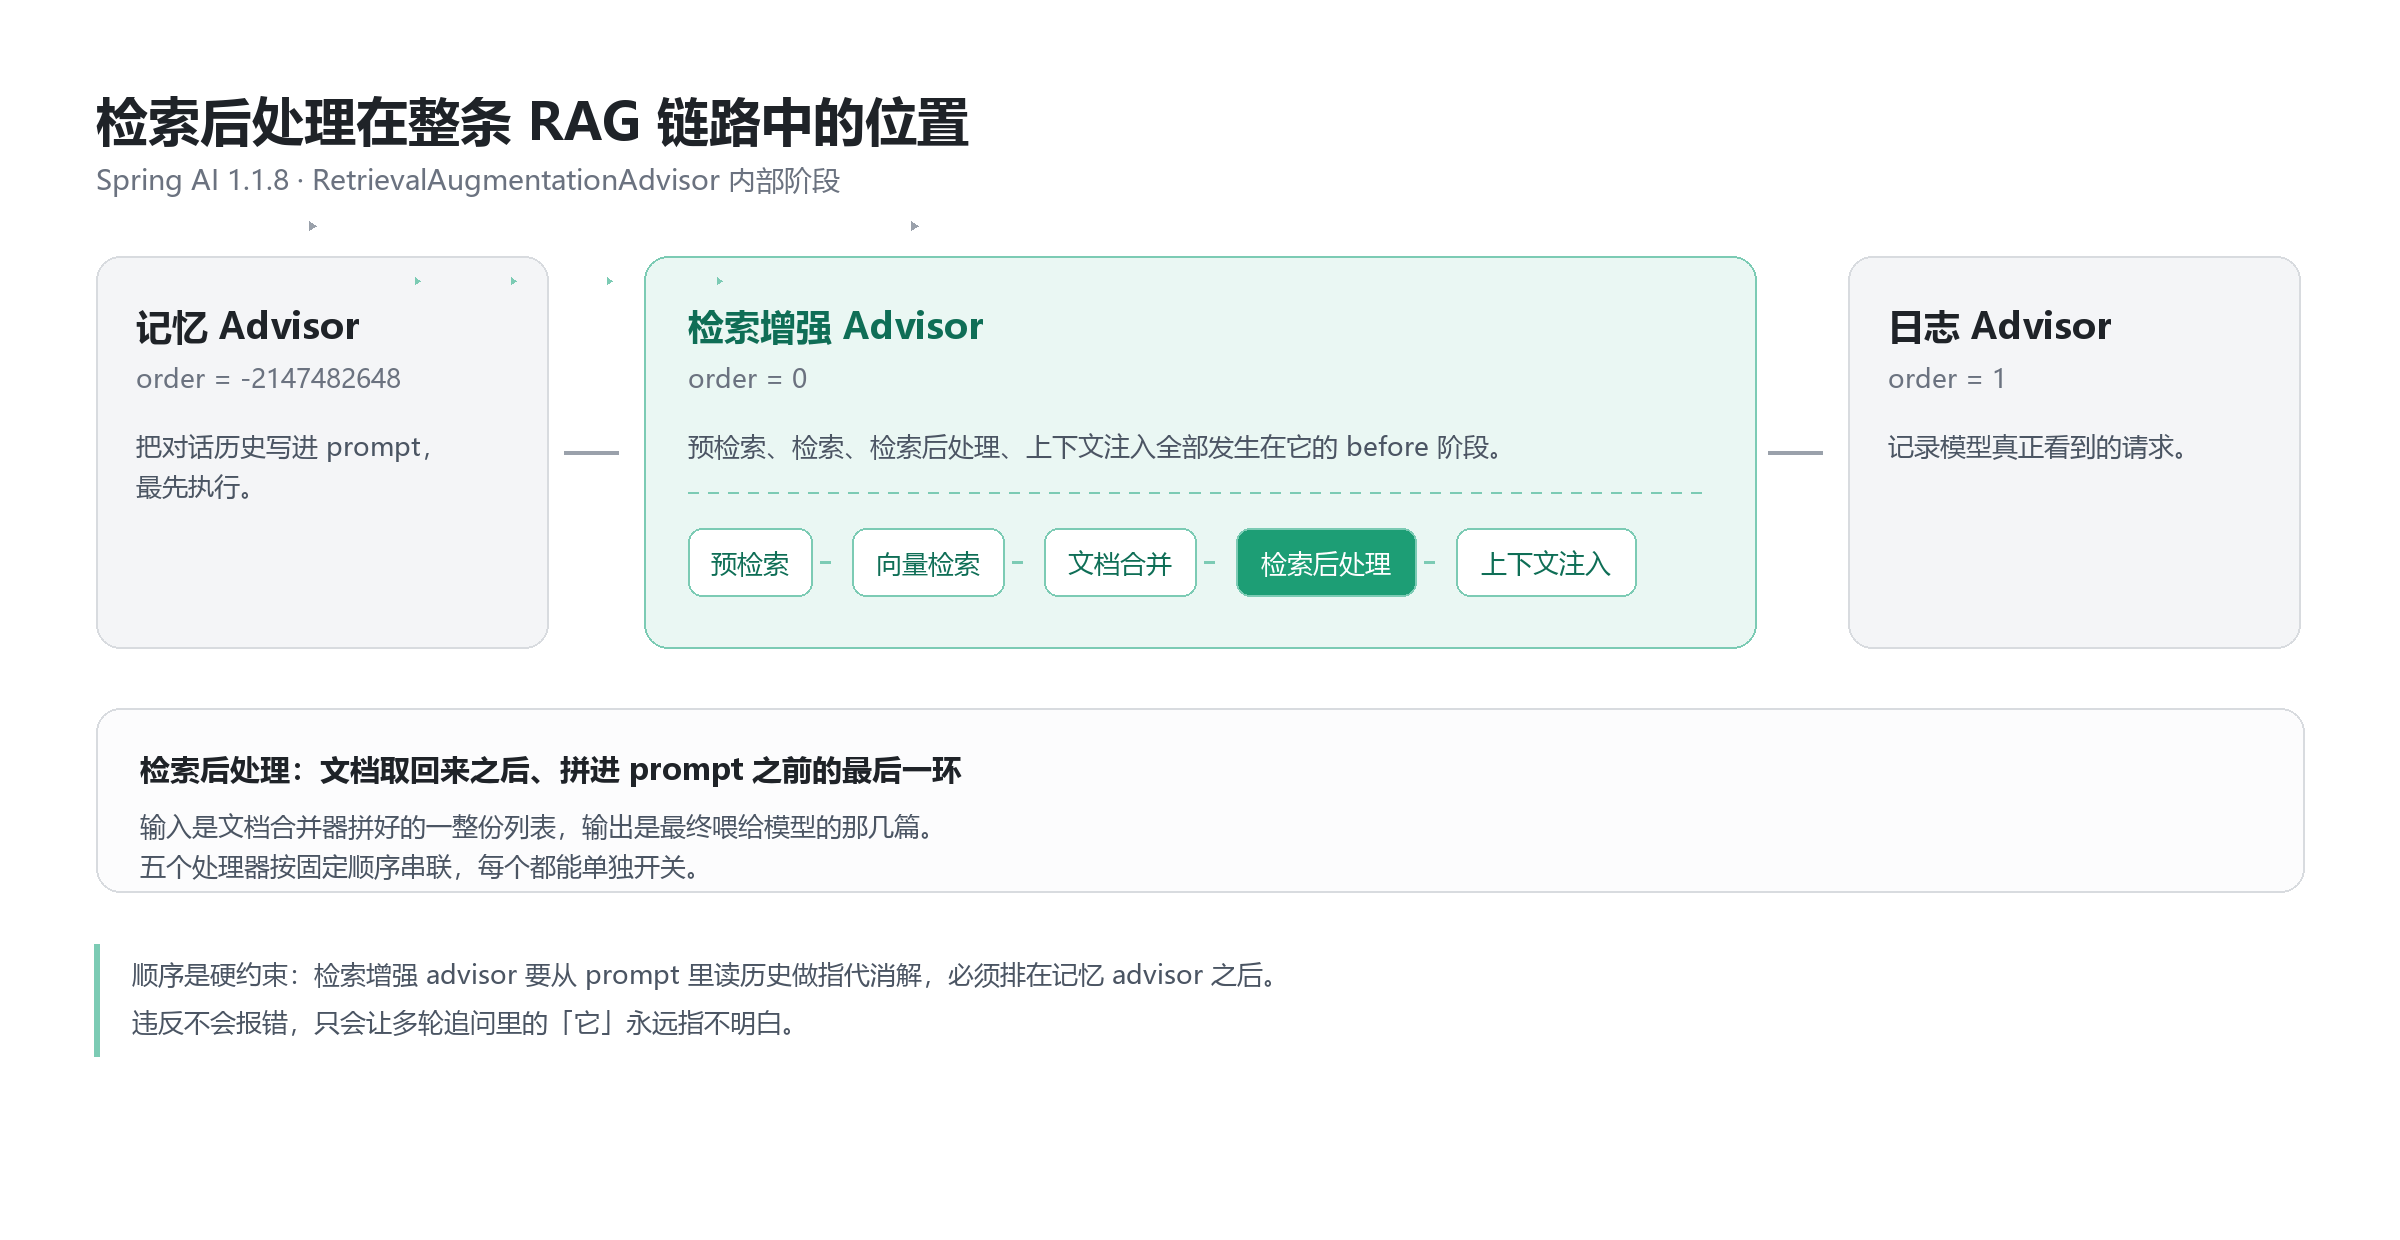
三个 advisor 的顺序和前几篇一样:记忆最先,检索增强居中,日志最后。检索后处理发生在检索增强 advisor 内部,排在文档合并之后、上下文注入之前。
# 图二:五个处理器与固定执行顺序
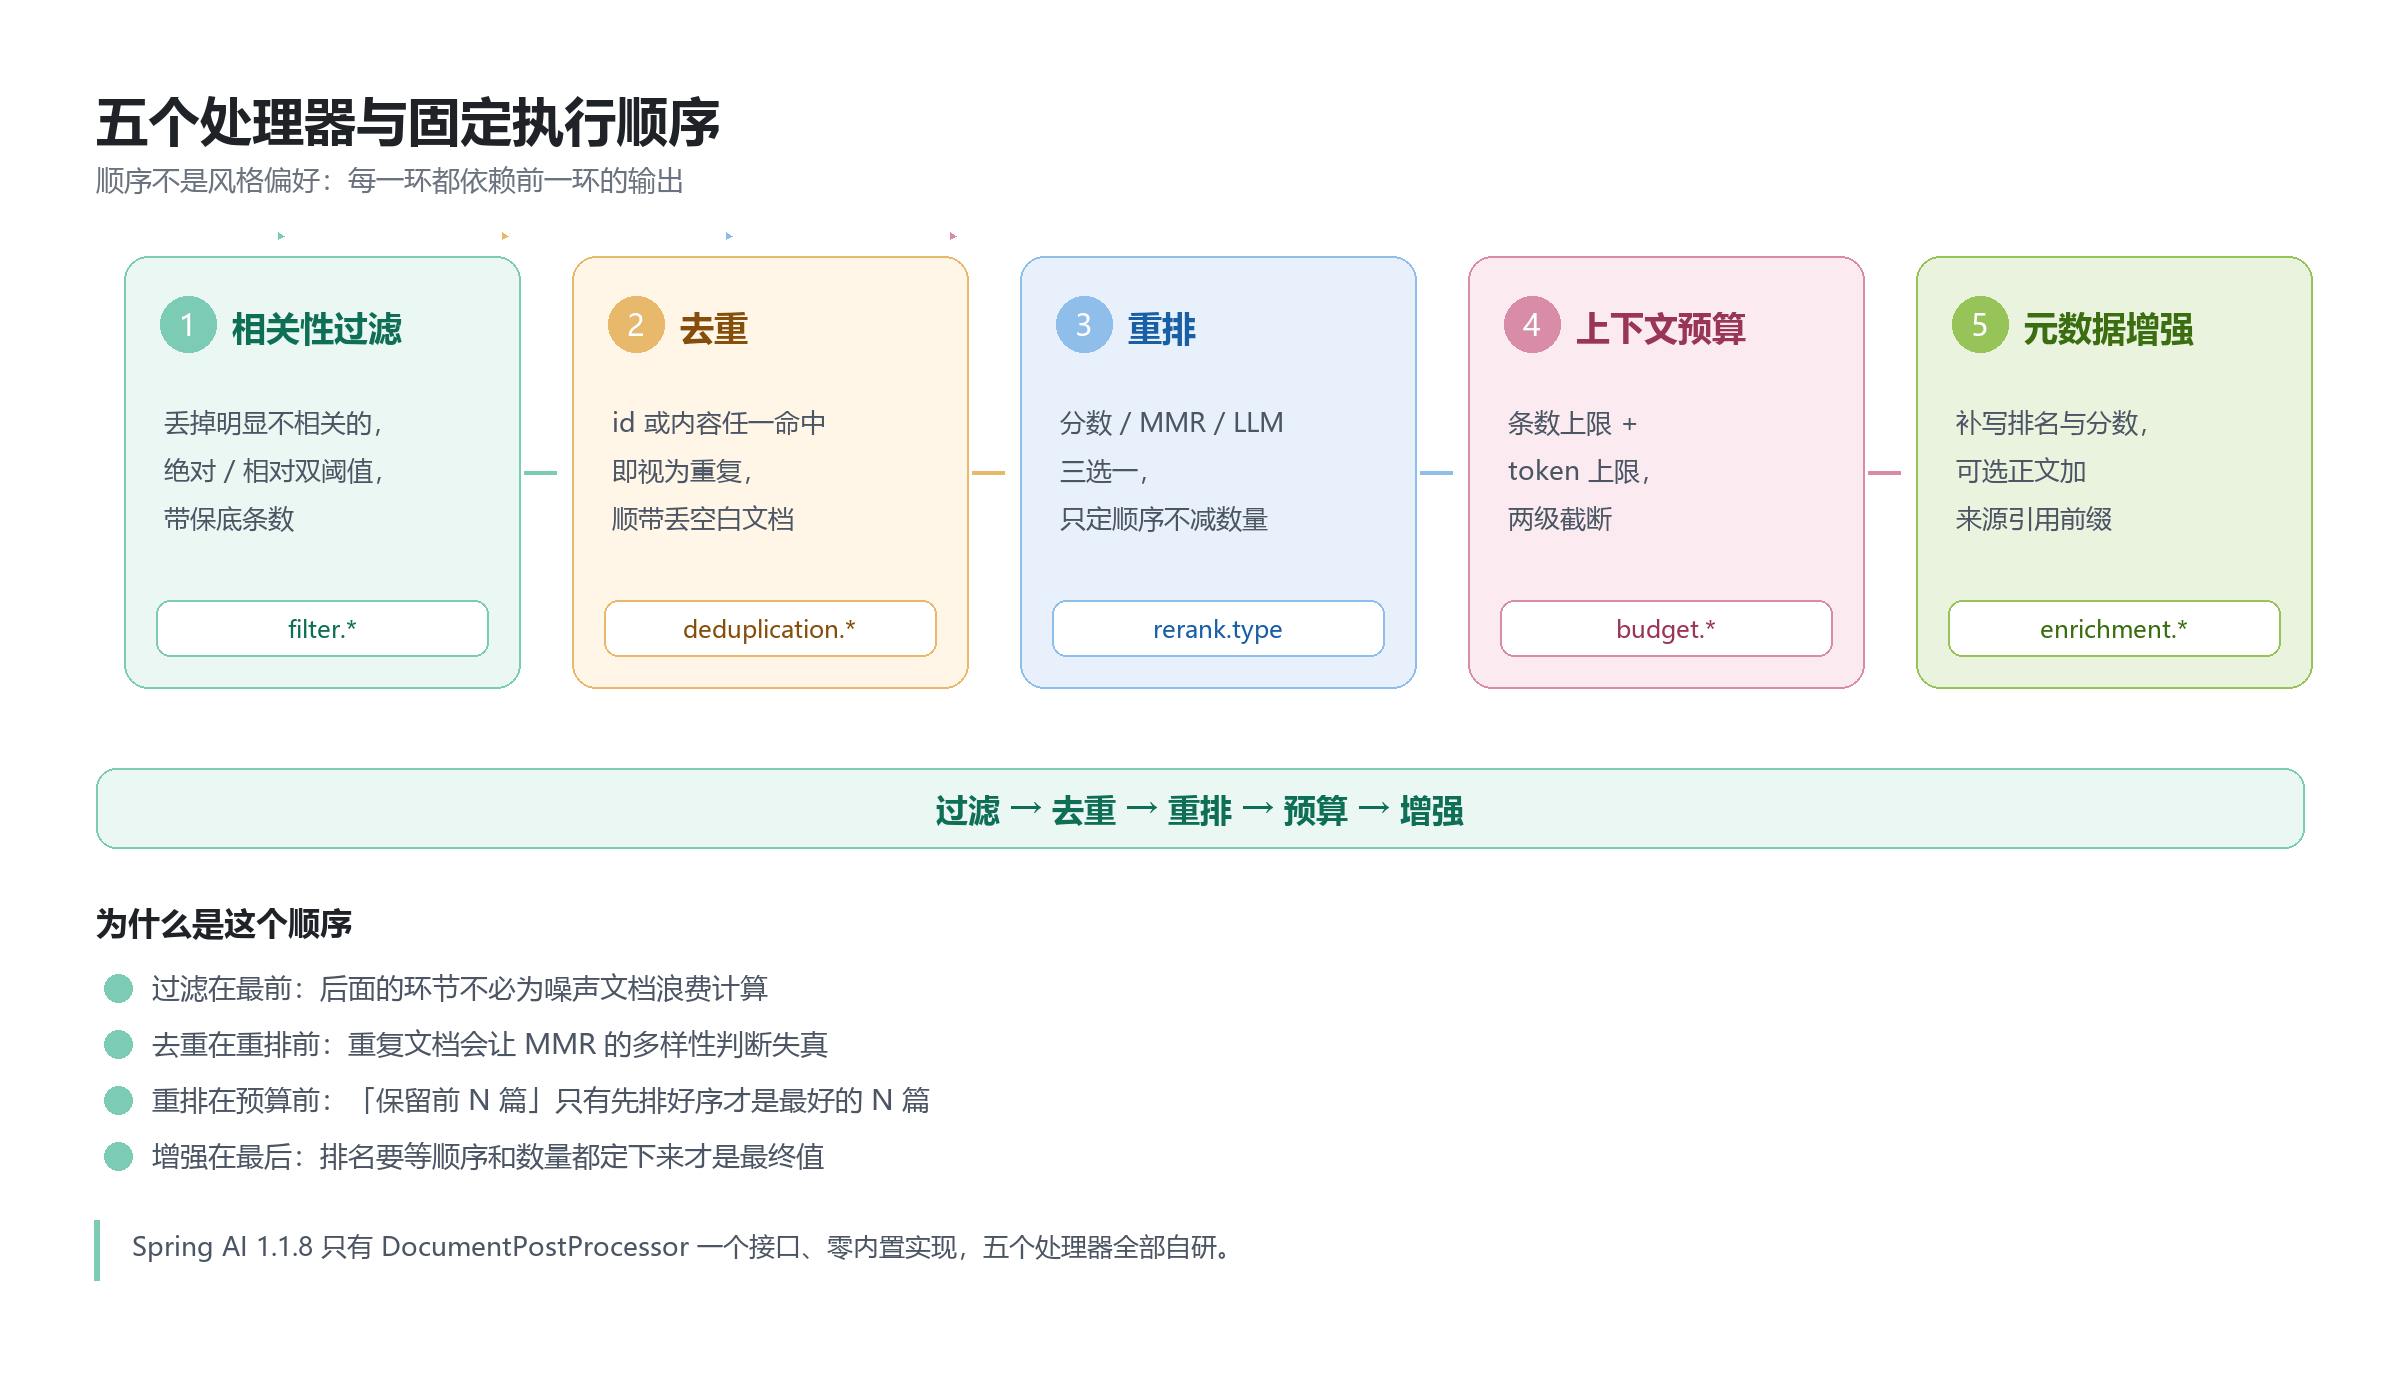
顺序不是风格偏好,而是有因果的:
- 过滤在最前,避免后面为噪声文档浪费计算;
- 去重在重排前,重复片段会让 MMR 的多样性判断失真;
- 重排在预算前,「保留前 N 篇」只有先排好序才是最好的 N 篇;
- 增强在最后,排名要等顺序和数量都定下来才准。
# 1. 相关性过滤
向量检索保证取满 topK,但不保证这 K 条都相关。本处理器支持两种阈值叠加:
- 绝对阈值:低于
min-score的丢弃。简单,但绝对值完全取决于 embedding 模型,默认 0(不生效)。 - 相对阈值:保留分数 ≥ 本次最高分 ×
relative-score-ratio的文档。与模型无关,是更实用的一档。
还加了 min-documents 保底:阈值调得过激时可能一篇都不剩,这比喂一篇勉强相关的更糟。过滤后若不足保底数,会按分数从高到低补齐。
# 2. 去重
ConcatenationDocumentJoiner 按对象身份去重,但多路查询经常召回「对象不同、内容一样」的片段。本处理器支持 id 或内容任一命中即重复,并可选剔除空白后再比较。
这里有个容易踩的坑:如果用「折叠成一个空格」的方式 normalize,中文 "中的\n模式" 会变成 "中的 模式",与原句对不上,去重失效。所以代码里用的是剔除空白,不是折叠。代价是英文 "a b" 与 "ab" 会被误判为相同 —— 知识库以中文为主,这个代价可以接受。
# 3. 重排
三种策略通过一个 rerank.type 切换:
similarity:按相似度分数降序,零成本;mmr:最大边际相关性,纯本地字符 bigram Jaccard,适合多路召回高度雷同时提升信息密度;llm:让模型给文档编号排序,效果最好但多一次大模型调用,默认不启用。
# 4. 上下文预算
启用多查询扩展后,召回量很容易变成「变体数 × topK」。预算支持 条数上限 + token 上限 两级截断,用 JTokkitTokenCountEstimator 估算。如果单篇就超 token 预算,代码选择保留而不是截断文本 —— 半句话比不相关内容更有害。
# 5. 元数据增强
给最终入选的文档补写 retrieval_rank 和 relevance_score,供日志与调优观测。另外支持把 [n] 来源:xxx 前缀写进正文,但默认关闭:因为 ContextualQueryAugmenter 默认只用 Document.getText() 拼上下文,元数据模型根本看不到。
还有一个实现坑点:Document.mutate() 内部 Builder.metadata(Map) 是直接持有原 Map 引用,所以增强前必须 new HashMap<>(...) 复制,否则会污染原文档。
# 图三:两个本地算法
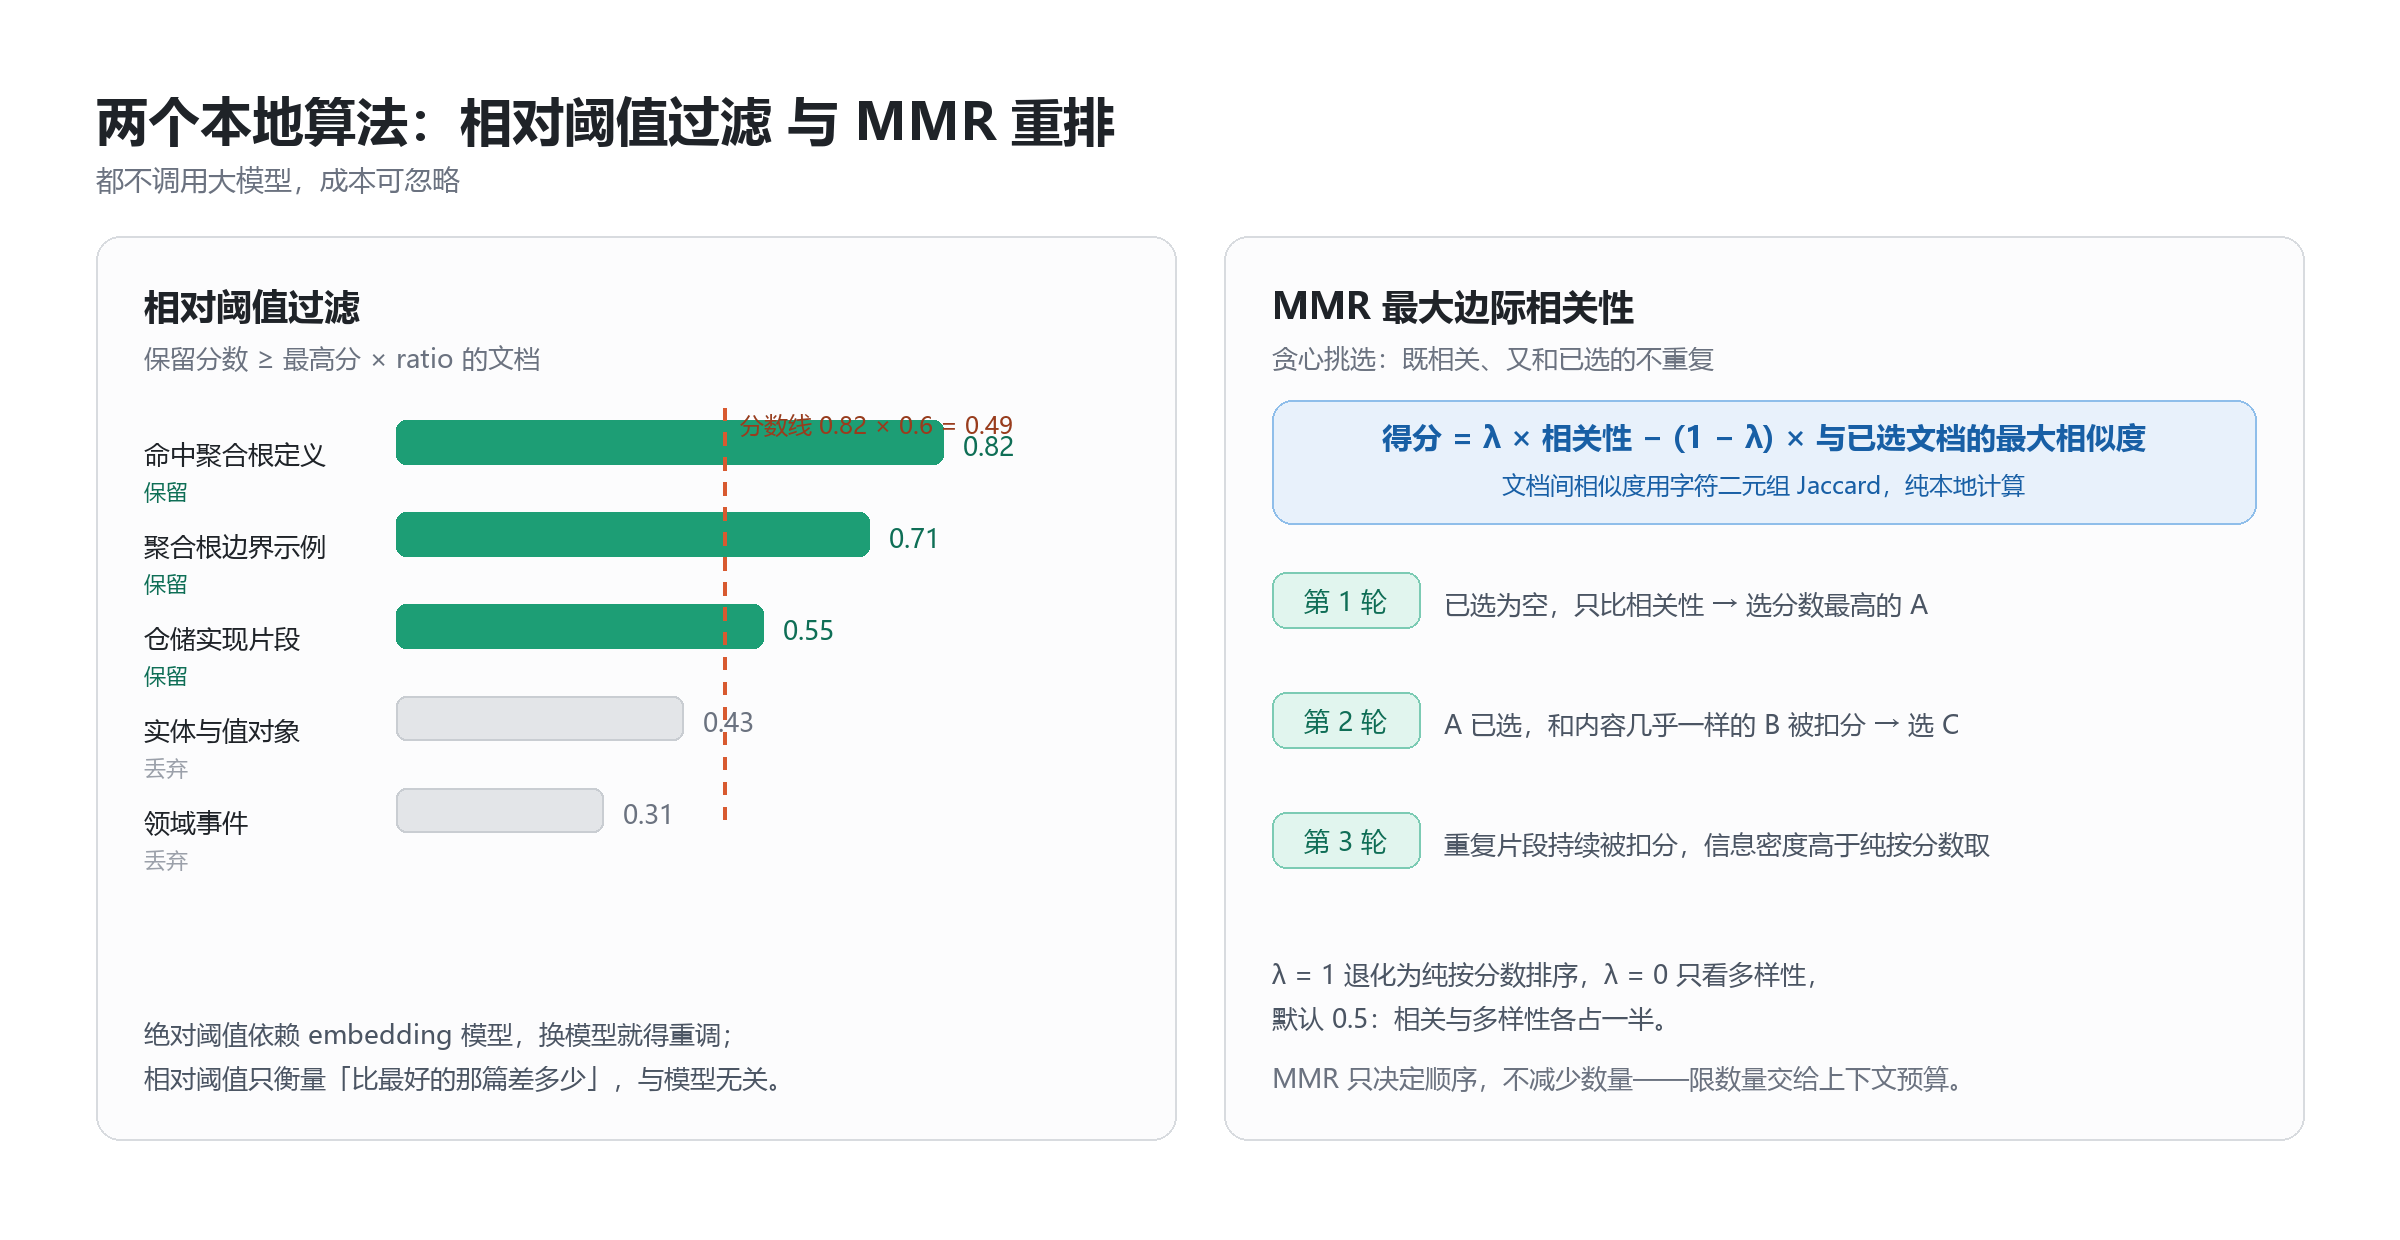
左图是过滤里更推荐的相对阈值:不关心 embedding 模型给出的是 0.82 还是 0.40,只关心「相对最好的那篇差多少」。右图是 MMR 的贪心过程:已选文档会拉高后续相似内容的惩罚分,从而选出信息密度更高的上下文。
# 装配方式
五个处理器收敛到 PostRetrievalPipeline 一个 record Bean 上,而不是各自注册成 DocumentPostProcessor Bean。原因和前几个阶段一样:这些组件由开关拼装、顺序有意义,各自注册成 Bean 后「哪些生效、以什么顺序」会变成容器隐式行为。
PostRetrievalConfig.composePostProcessors(...) 还抽成了静态纯函数,专门方便单测直接断言「某个开关打开后链路里到底有没有它」,不需要启动 Spring。
# 默认策略:启用不改变行为
默认只开零成本且稳妥的环节:
- 过滤:绝对 / 相对阈值都设 0(不生效),只有
min-documents: 1保底; - 去重:开;
- 重排:
similarity(按分数降序,本身就是向量库的自然顺序); - 预算:
max-documents: 0、max-tokens: 0,不截断; - 增强:只写元数据,不加引用前缀。
也就是说把这套模块接上去,检索结果与改造前逐条一致;所有行为差异都来自显式打开的开关。
# 配置前缀
mu-ai:
  rag:
    post-retrieval:
      enabled: true
      filter:
        enabled: true
        min-score: 0.0
        relative-score-ratio: 0.0
        min-documents: 1
      deduplication:
        enabled: true
        by-content: true
        by-id: false
        normalize-whitespace: true
      rerank:
        enabled: true
        type: similarity
      budget:
        enabled: true
        max-documents: 0
        max-tokens: 0
      enrichment:
        enabled: true
        include-rank-metadata: true
        include-citation-prefix: false
配置项全部集中在 mu-ai.rag.post-retrieval 前缀下,和检索阶段 mu-ai.rag.retrieval 拆成两个独立块,避免调优时混在一起。
# 验证
新增 8 个测试类(7 个纯逻辑 / 装配,1 个 LLM 重排打 @Tag("llm"))。mvn -B test -DexcludedGroups=llm 跑下来 65 个用例全绿;LLM 重排单独跑也通过了,把顺序从 noise, answer, partial 排成了 answer, partial, noise。
# 下一步
检索后处理已经可以把「哪些文档进上下文」收拾干净。再往后看,生成阶段主要剩下两件事:一是上下文注入的模板能不能让模型更好地利用这些片段;二是模型回答时能不能更稳定地拒答空检索。这两个都围绕 ContextualQueryAugmenter 和 system 提示词,留到下一篇。