✨ 我是 Muzi 的「文章捕手」,擅长在文字的星海中打捞精华。每当新的篇章诞生,我就会像整理贝壳一样,将思想的闪光点串成珍珠项链~
本文详细阐述了Mu-ai-agent中RAG链路的检索阶段设计与实现,将检索参数、文档合并器、上下文注入器及检索后处理器独立成mu-ai.rag.retrieval配置模块。设计包含三个关键环节:“文档检索”支持元数据过滤和显式装配;“文档合并”实现多查询结果合并策略配置;“检索后处理”通过自研去重与截断处理保证文档质量。配置项支持灵活调优且保持默认行为一致,确保升级框架时稳定性。该方案清晰分层、可控可观测,明确了“给模型喂什么上下文”的流程,提升了系统的扩展性和实用性。
# Mu-ai-agent-12
# 前言
#11 用图把预检索(query 加工)讲了一遍,这篇回到 RAG 链路的下一截:检索阶段(retrieval phase)。
预检索解决的是「拿什么去检索」——把含混的多轮追问补全、改写成检索友好的问题;检索阶段解决的是「拿回文档之后怎么办」——多路结果怎么合并、重复片段怎么去掉、最终喂给模型的上下文窗口怎么控制。
本次实现把检索参数、文档合并器、上下文注入器和检索后处理器从预检索配置里拆出来,单独成一个 mu-ai.rag.retrieval 配置前缀。下面是新增部分的完整位置。
# 图一:检索阶段在整条 RAG 链路中的位置
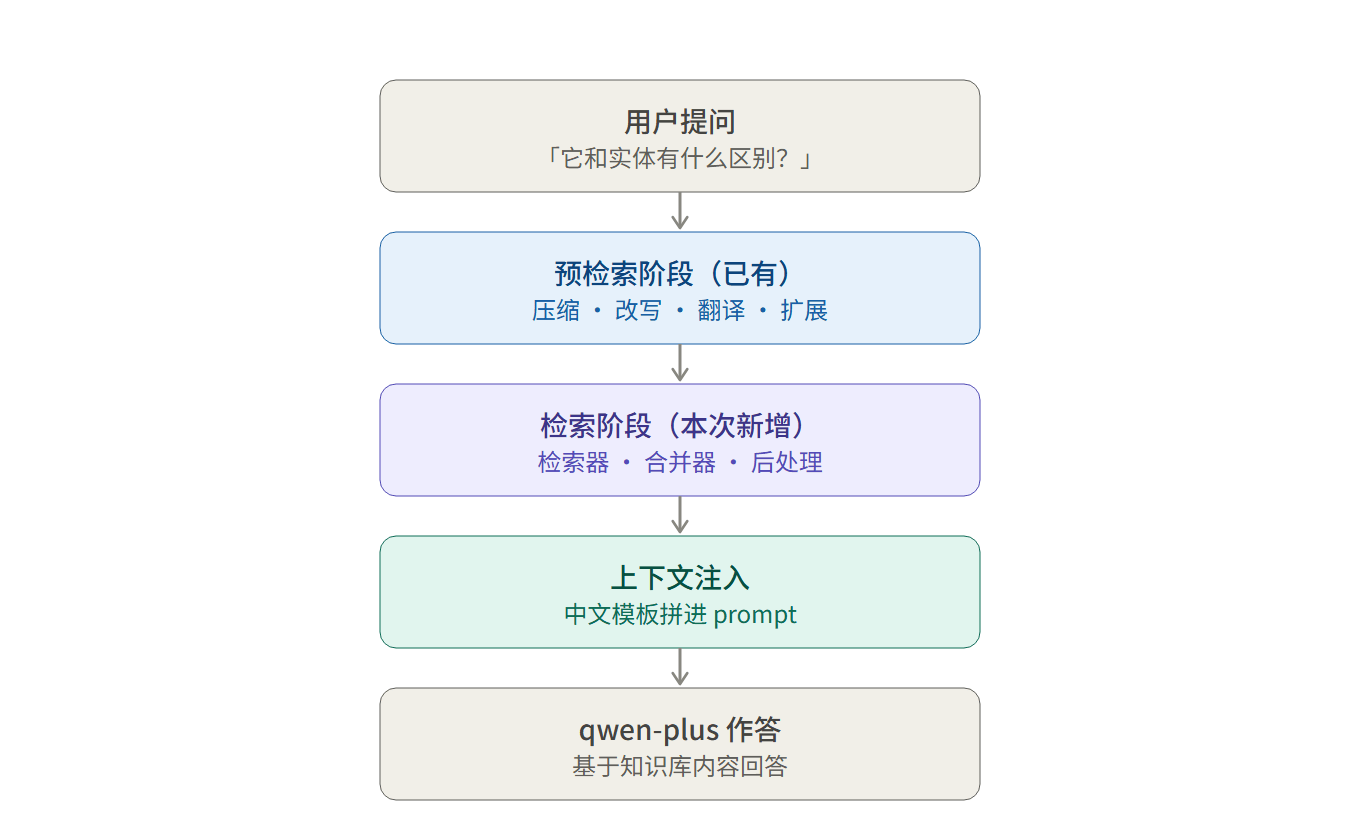
链路从上到下的顺序是硬约束:
- 记忆 advisor 最先跑(order = -2147482648),把对话历史写进 prompt;
- 检索增强 advisor 居中(order = 0),预检索、检索、上下文注入都发生在它的
before阶段; - 日志 advisor 最后跑(order = 1),记录的是「模型真正看到的请求」。
检索增强 advisor 要从 prompt 里读历史做指代消解,所以它必须排在记忆 advisor 之后。这个依赖关系写在接口签名上是看不到的,违反也不会报错,只会让「它和实体有什么区别?」里的「它」永远指不明白。
# 新增文件与职责
| 文件 | 职责 |
|---|---|
RetrievalProperties |
检索阶段配置:search / joiner / augmenter / post-retrieval 四组 |
RetrievalConfig |
装配检索器、合并器、后处理器、上下文注入器、检索增强 advisor |
DeduplicationDocumentPostProcessor |
按内容去重 + maxDocuments 截断 |
RetrievalConfigTest |
装配与默认值断言 |
DeduplicationDocumentPostProcessorTest |
去重/截断纯逻辑测试 |
同时改造了两个既有文件:
PreRetrievalProperties移除了retrieval和augmenter,只保留 query 加工相关配置;PreRetrievalConfig从 4 个 Bean 精简到 1 个(preRetrievalPipeline),检索相关 Bean 全部迁到RetrievalConfig。
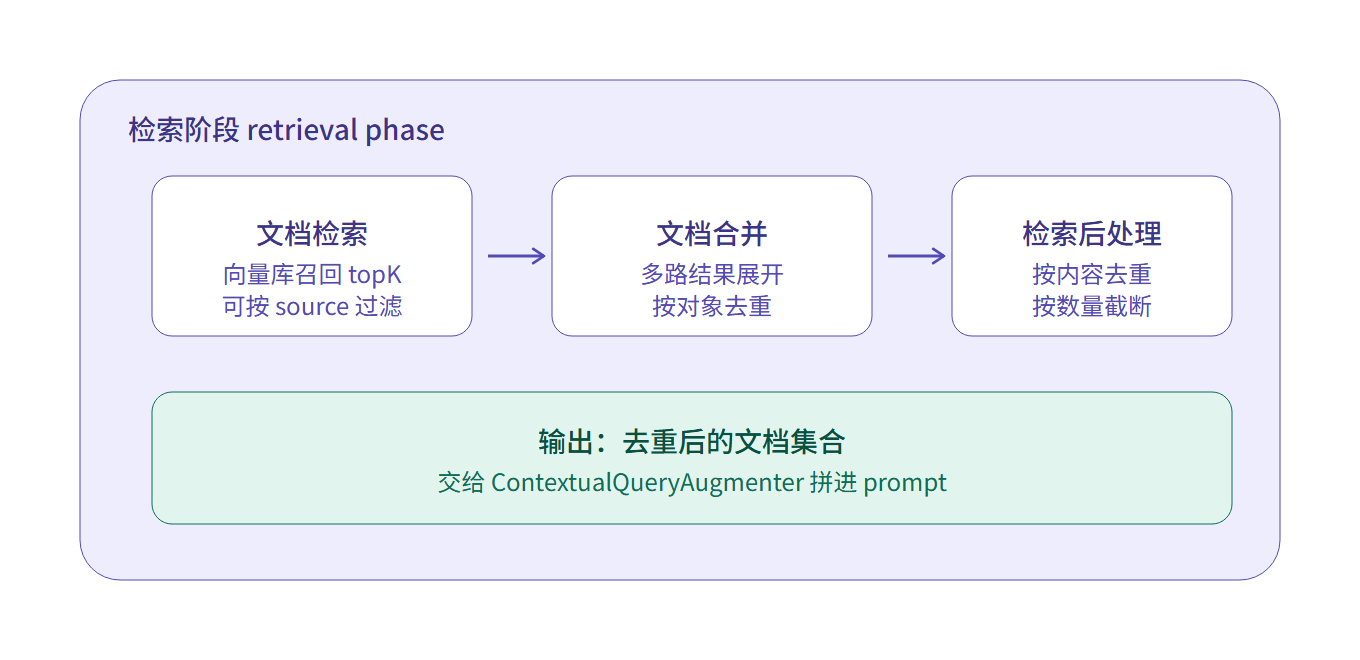
# 图二:检索阶段内部的三个环节
# 1. 文档检索(DocumentRetriever)
用 VectorStoreDocumentRetriever 显式装配。相比改造前新增了元数据过滤能力:配置的 filter-expression 会由 FilterExpressionTextParser 解析成 Filter.Expression。
因为 DocumentLoader 在灌库时已经给每个 chunk 写入了 source 元数据(文件名),现在可以直接按文档过滤:
search:
  filter-expression: "source == '什么是聚合,什么是聚合根?.md'"
  filter-expression: "source in ('a.md', 'b.md')"
表达式解析失败会抛 IllegalArgumentException,避免过滤条件悄悄失效成「不过滤」。
# 2. 文档合并(DocumentJoiner)
开启多查询扩展后,一条问题会被扩成 3 个变体,各自检索后产生 3 份文档列表。ConcatenationDocumentJoiner 负责把它们展开合并成一份。之前这一环吃的是框架默认值,现在显式装配并纳入配置开关。
# 3. 检索后处理(DocumentPostProcessor)
Spring AI 1.1.8 只提供了 DocumentPostProcessor 接口,没有内置实现,所以自研了 DeduplicationDocumentPostProcessor:
- 按文本内容去重(合并器只按对象身份去重,拦不住内容相近的 chunk);
- 丢弃空白内容文档;
- 配置
max-documents后可按数量截断。
# 配置项一览
mu-ai:
  rag:
    retrieval:
      search:
        top-k: 4
        similarity-threshold: 0.0
        filter-expression: ""
      joiner:
        enabled: true
        type: concatenation
      augmenter:
        allow-empty-context: true
      post-retrieval:
        enabled: true
        max-documents: 0
deduplicate-by-content: true| 配置项 | 默认值 | 作用 |
|---|---|---|
search.top-k |
4 | 每条查询召回上限 |
search.similarity-threshold |
0.0 | 相似度阈值,≤0 视为不设 |
search.filter-expression |
"" | 元数据过滤表达式 |
joiner.enabled |
true | 文档合并器开关 |
joiner.type |
concatenation | 合并策略 |
augmenter.allow-empty-context |
true | 空结果时是否交给模型 |
post-retrieval.enabled |
true | 后处理开关 |
post-retrieval.max-documents |
0 | 最终文档上限,0=不截断 |
post-retrieval.deduplicate-by-content |
true | 按内容去重 |
默认值全部对齐改造前:topK=4、阈值=0.0、allow-empty-context=true。目的是让「新增检索阶段优化」本身不改变检索结果,差异只来自显式开启的新能力。
# 几个设计取舍
为什么显式配置每个环节。 RetrievalAugmentationAdvisor 对未设置的组件会回退框架默认值。默认值在升级 Spring AI 时可能变化,而「去不去重、用哪套模板」都是影响回答质量的决策,应该由项目配置明确表达。
为什么合并器/后处理器允许返回 null。 关闭时返回 null,装配 advisor 时做非空判断跳过。这与 queryExpander 的处理方式一致(框架内部对这几个字段都有 null 判断),避免为了「关掉」还得提供一个空实现 Bean。
为什么把检索配置从预检索里拆出来。 预检索解决「query 好不好检索」,检索阶段解决「文档取得好不好」,两个阶段语义、默认值和调优方向都不同。硬塞在一起会让 YAML 结构和类注释都说不清。
# 验证结果
mvn -B test -DexcludedGroups=llm 全部通过,共 32 个用例(本次新增 10 个)。启动日志确认装配生效:
向量检索参数:topK=4, similarityThreshold=不设阈值, filterExpression=无
文档合并器已装配:ConcatenationDocumentJoiner
# 小结
两张图各说一句话:
- 图一:检索阶段嵌在 advisor 链中间,前面是记忆注入,后面是上下文注入与日志;
- 图二:检索阶段内部是「取回 → 合并 → 净化」三段流水线,最终输出一份去重后的文档集合。
检索阶段优化的核心就是把「给模型喂什么上下文」这件事一层层摆出来:先显式配置取回规则,再显式合并多路结果,最后做一道内容去重与截断。每一步都可开关、可观测,也都可以在升级框架时保持稳定行为。
项目地址:mu-ai-agent